Ще кілька років тому фраза «намалюй кота-астронавта в стилі Ван Гога» звучала як жарт для вечірки. Сьогодні вона перетворюється на готову картинку за пів хвилини, причому на звичайному домашньому комп’ютері. Здебільшого це заслуга однієї моделі, яка у 2022 році потрапила у відкритий доступ і запустила справжній вибух творчості, експериментів і гучних суперечок.
У цій статті я розповім, як усе влаштовано всередині, що ця модель уміє, чим відрізняються її версії та з чого почати, якщо хочеться спробувати самому. Без зайвої математики, зате з прикладами.
Що таке Stable Diffusion і звідки вона взялася
Stable Diffusion — це модель глибокого навчання з відкритим кодом від компанії Stability AI, випущена у 2022 році. Вона генерує деталізовані та фотореалістичні зображення на основі текстових описів. Ви пишете фразу, а нейромережа дістає з шуму картинку, яка їй відповідає.
Важливо, що вона не склеює готові фрагменти з інтернету, як іноді думають. Модель вивчила статистичні закономірності між словами та візуальними образами на величезному наборі підписаних зображень. Тому кожна нова картинка створюється з нуля, хоча стиль і манера можуть нагадувати те, на чому модель навчалася.
Народження моделі
В основі лежить наукова робота про латентні дифузійні моделі, яку підготувала група CompVis при Мюнхенському університеті Людвіга-Максиміліана разом із дослідниками з Runway. Stability AI надала обчислювальні ресурси та допомогла довести проєкт до публічного релізу. Датасет для навчання зібрала німецька некомерційна організація LAION: у ньому мільярди пар «зображення плюс підпис», зібраних з відкритого інтернету.
Публічний реліз відбувся наприкінці серпня 2022 року. На той момент потужні генератори зображень, як-от DALL·E 2 від OpenAI чи Midjourney, працювали лише як закриті сервіси. Хочеш спробувати, то стань у чергу, плати й дотримуйся чужих правил.
Чому відкритість змінила все
Stability AI виклала у вільний доступ не тільки код, а й навчені ваги моделі. Це означало, що її можна завантажити, запустити на власній відеокарті та навіть доучити під свої потреби. Варто уточнити, що ліцензія все ж має обмеження на шкідливе використання, тож це не «вільне ПЗ» у строгому розумінні.
Наслідки були майже миттєвими. За кілька тижнів з’явилися зручні веб-інтерфейси, плагіни для графічних редакторів, десятки оптимізацій, які дозволили працювати на дедалі скромніших комп’ютерах. Спільнота зробила для моделі більше, ніж будь-яка команда з десятком інженерів.
Як це працює без складної математики
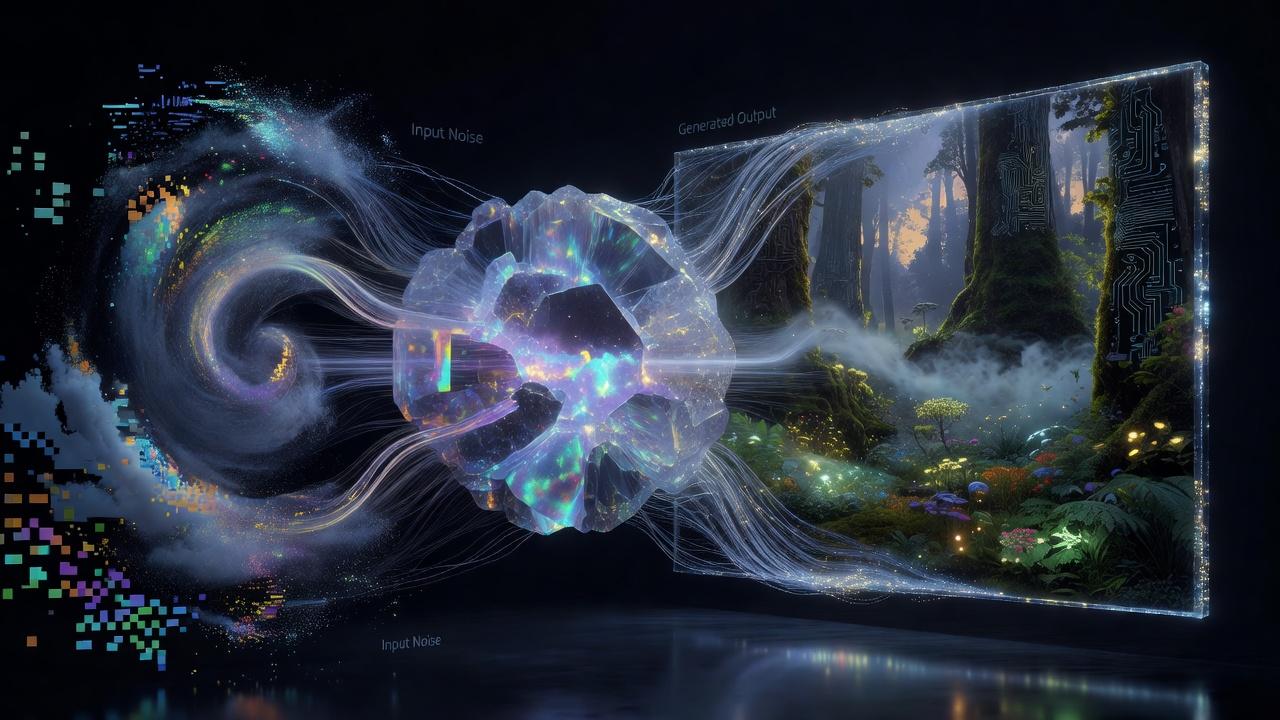
Принцип напрочуд простий, якщо пояснювати його образами. Уявіть фотографію, на яку поступово сиплеться «сніг», як на старому телевізорі без антени. Після сотень кроків від картинки лишається суцільна сіра каша. Тепер уявіть, що нейромережа навчилася цей процес повертати назад.
Спочатку шум, потім картинка
Під час навчання моделі показують реальні зображення, на які штучно додають шум різної сили. Завдання нейромережі: вгадати, який саме шум додали. Це повторюється мільярди разів, і зрештою вона дуже добре відрізняє «корисний сигнал» від випадкового сміття.
Під час генерації все відбувається навпаки. Модель отримує випадковий шум і крок за кроком прибирає його, щоразу наближаючись до осмисленого зображення. Зазвичай вистачає від 20 до 50 кроків. Ніби скульптор, який бачить у шматку каменю майбутню статую й відсікає зайве.
Прихований простір, який економить пам’ять
Головний трюк Stable Diffusion у тому, що вона працює не з пікселями напряму, а зі стисненим поданням картинки, яке називають латентним простором. Спеціальний кодувальник (VAE) зменшує зображення 512×512 до компактного масиву розміром 64×64 з кількома каналами. Усі «роздуми» над шумом відбуваються саме там, а наприкінці декодер розгортає результат у повноцінну картинку.
Завдяки цьому обчислень потрібно в рази менше, ніж у моделей, що працюють просто з пікселями. Саме тому генерація стала можливою на побутових відеокартах, а не лише на серверах із десятками тисяч доларів вартості.
Як текст потрапляє в зображення
Ваш запит спершу проходить через текстовий кодувальник. У перших версіях це був CLIP від OpenAI, який навчений зіставляти зображення та підписи до них. Він перетворює слова на числові вектори, а ті підказують основній мережі, у який бік «рухати» шум.
Основна робоча частина називається U-Net. У першій версії вона мала близько 860 мільйонів параметрів, що за сьогоднішніми мірками скромно. У новіших поколіннях її замінили трансформерною архітектурою, але ідея лишилася тією самою.
Що вміє Stable Diffusion
Генерація за текстом лише найвідоміша функція. Модель можна застосовувати й іншими способами, і саме вони найчастіше потрібні на практиці.
- Text-to-image: створення картинки з нуля за описом.
- Image-to-image: перетворення наявного зображення за новим запитом. Наприклад, з грубого начерку виходить завершена ілюстрація.
- Inpainting: заміна виділеної частини зображення. Можна прибрати з кадру зайву людину або «домалювати» інший одяг.
- Outpainting: розширення картинки за її межі.
- Збільшення роздільності: апскейл із дотворенням дрібних деталей.
Коли я вперше спробував inpainting, то вирішив «пересадити» старій сімейній світлині нормальне небо замість засвіченого білого фону. З третьої спроби вийшло так, що ніхто з рідних не здогадався про втручання. Тоді я й зрозумів, що це вже не іграшка, а повноцінний інструмент.
Версії: від 1.4 до 3.5
З моменту релізу модель пройшла кілька великих оновлень. Кожне з них змінювало якість, роздільність і вимоги до заліза.
| Версія | Рік | Що важливо знати |
|---|---|---|
| 1.4 / 1.5 | 2022 | Базова роздільність 512×512. Саме на 1.5 з’явилася більшість спільнотних доробок. |
| 2.0 / 2.1 | 2022 | Новий текстовий кодувальник OpenCLIP, варіанти до 768×768. Багато користувачів лишилися на 1.5 через гірші результати з людьми та стилями. |
| SDXL 1.0 | 2023 | Рідна роздільність 1024×1024, помітно кращі композиція та деталізація. |
| 3 / 3.5 | 2024 | Архітектура Multimodal Diffusion Transformer, краще розуміння складних запитів і тексту на зображеннях. |
Версія 1.5 вийшла не від самої Stability AI, а від Runway. Це добра ілюстрація того, наскільки децентралізованим став проєкт. Дискусії про те, яка версія «краща», досі тривають, бо відповідь залежить від завдання: для аніме-стилю одні моделі, для фотореалізму інші.
З чого почати: залізо та інтерфейси
Найпоширеніше запитання новачків звучить так: чи потрібен мені потужний комп’ютер? Відповідь залежить від того, чи хочете ви тримати все в себе, чи вам достатньо онлайн-сервісів.
Локальний запуск
Під час релізу розробники називали комфортним мінімумом відеокарту з 10 ГБ пам’яті. Згодом з’явилися оптимізації, і сьогодні SD 1.5 запускається навіть на картах із 4–6 ГБ, хоча й повільніше. Для SDXL та новіших моделей вимоги вищі, і 8–12 ГБ вже виглядають розумним мінімумом.
Найпопулярніші програми для роботи з моделлю:
- AUTOMATIC1111 Web UI: класичний варіант із купою розширень, добрий для старту.
- ComfyUI: вузловий інтерфейс, де процес збирається з блоків. Складніший, зате дає повний контроль.
- InvokeAI: охайний інтерфейс, зручний для художників.
Онлайн-варіанти
Якщо відеокарти немає, можна скористатися хмарними сервісами. Stability AI має власні продукти, є сторонні сайти та Google Colab, хоча умови безкоштовного використання там змінюються. Для знайомства з технологією цього вистачає, але справжня гнучкість починається саме на власній машині.
Моделі та доповнення до них зазвичай шукають на Hugging Face і Civitai. Другий ресурс особливо любить спільнота: там тисячі спільнотних чекпойнтів, LoRA та прикладів запитів. Лише дивіться на ліцензію й не завантажуйте файли з підозрілих джерел.
Налаштування, які вирішують результат
Одного хорошого запиту мало. Дві людини з однаковим текстом можуть отримати зовсім різні результати через кілька параметрів, які на початку здаються магією.
Seed
Це число, з якого починається випадковий шум. Якщо зафіксувати seed і не чіпати решту параметрів, ви отримаєте ту саму картинку. Зручно, коли хочеться змінити одну деталь у запиті й побачити, що саме це змінило.
CFG scale
Показує, наскільки суворо модель має триматися вашого тексту. Низькі значення дають більше фантазії, але картинка може «попливти». Надто високі роблять кольори різкими, а зображення перенасиченим. Для більшості випадків працюють значення приблизно від 5 до 9.
Кількість кроків і семплер
Кроки визначають, скільки разів модель прибирає шум. Понад певну межу різниця майже непомітна, тож 25–30 кроків зазвичай достатньо. Семплер (Euler, DPM++ та інші) відповідає за спосіб цього прибирання і впливає на характер дрібних деталей.
Негативний запит
Окреме поле, куди вписують те, чого на картинці бути не має: «розмиття», «зайві пальці», «водяні знаки». Це стало маленьким ритуалом кожного, хто працює з моделлю, бо руки в ранніх версіях часто виходили з сюрпризами. Мій перший кіт, до речі, мав п’ять лап і дивився так, наче сам не вірив у те, що бачить.
Тонке налаштування: LoRA, DreamBooth, ControlNet
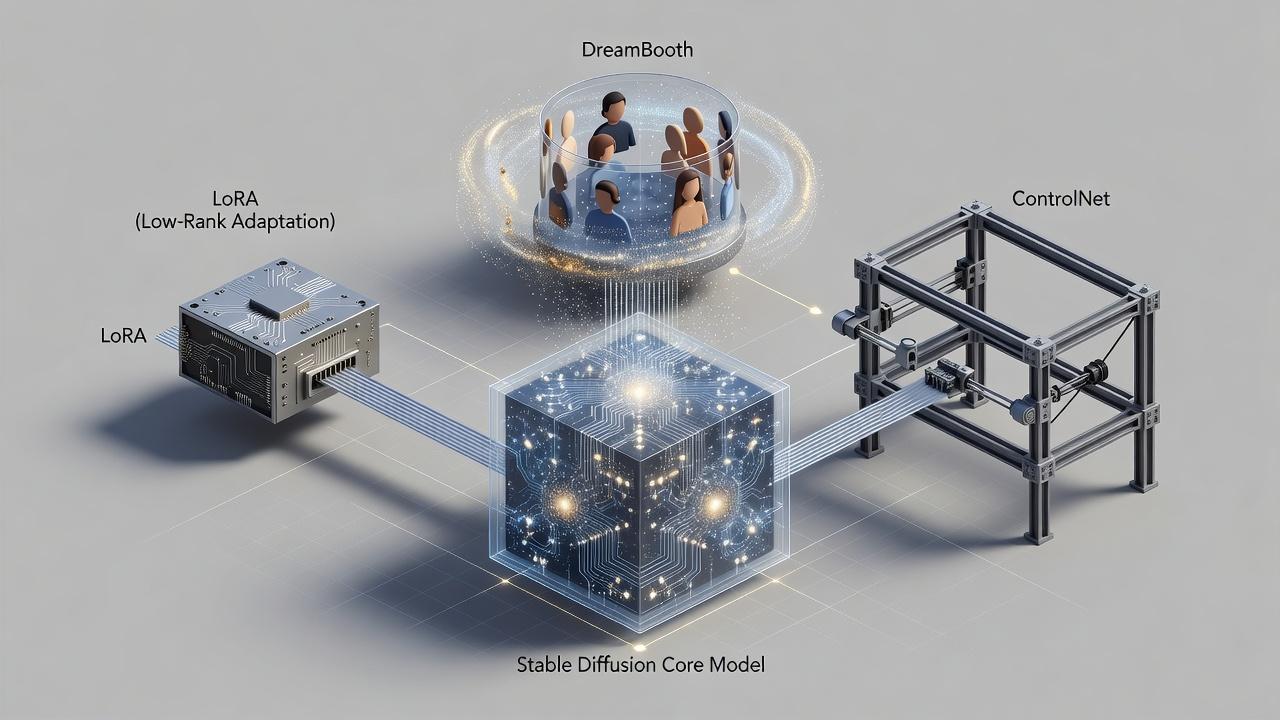
Справжня сила Stable Diffusion розкривається, коли її починають підлаштовувати під себе. Базова модель знає багато всього, але не знає вашого обличчя, вашого логотипа чи манери конкретного ілюстратора.
DreamBooth і textual inversion дозволяють навчити модель новому об’єкту чи стилю на кількох десятках прикладів. LoRA ще практичніша: це невеликий файл-надбудова, що підключається до основної моделі й змінює її поведінку. Такі файли важать від кількох до сотень мегабайтів, тож ними легко ділитися.
ControlNet, розроблений Львмінем Чжаном у 2023 році, вирішив іншу проблему: контроль над композицією. Ви можете подати на вхід позу людини, контури, карту глибини, і модель збудує зображення навколо цього каркаса. Для дизайнерів це було переломом, бо замість лотереї з випадковими результатами з’явилася передбачуваність.
Де це застосовують насправді
Найочевидніше застосування лежить у ілюстрації й концепт-арті. Художники швидко перебирають десятки ідей, а потім доопрацьовують найкращу вручну. Хтось використовує модель для обкладинок, постерів, текстур для ігор, візуалізації інтер’єрів.
Я знаю людину, яка робить настільні рольові ігри й раніше місяцями шукала ілюстрації до персонажів. Тепер вона генерує начерки за вечір, а потім замовляє фінальні версії в живих художників. Парадоксально, але кількість замовлень у неї не зменшилась, а виросла, бо ідеї стали чіткішими.
Є й менш помітні сфери: прототипи рекламних кампаній, візуалізація архітектурних задумів, навчальні матеріали, мода. Але що ширше застосування, то гостріше постають питання, на які поки немає однозначних відповідей.
Суперечки навколо технології
Найбільше питань викликає навчальний датасет. Мільярди зображень зібрано з інтернету, і серед авторів цих робіт багато тих, хто ніколи не давав на це згоди. У 2023 році Getty Images подала позови проти Stability AI, а група художників ініціювала колективний позов у США. Судові процеси тривають, і юридична відповідь на запитання, чи є таке навчання добросовісним використанням, ще не сформована.
Є й проблема зловживань. Відкритість моделі означає, що з неї можна прибрати фільтри безпеки, а це відкриває шлях до дипфейків і неприємного контенту. Розробники додавали обмеження, проте повністю контролювати те, що робить спільнота з відкритими вагами, неможливо.
Окремо варто згадати хитке становище самої компанії. У 2024 році з посади керівника пішов Емад Мостак, який був обличчям проєкту, а Stability AI опинилася під тиском через витрати на обчислення. Це нагадування про те, що навіть успішні відкриті проєкти не завжди мають простий бізнес за спиною.
Що далі
Нові покоління моделей дедалі краще розуміють довгі описи, правильно відтворюють текст на картинках і справляються з анатомією. Паралельно конкуренти, від Midjourney до Flux, підіймають планку, тож Stable Diffusion доводиться доводити свою цінність не лише відкритістю, а й якістю.
Для мене головна заслуга цієї моделі навіть не в красивих картинках. Вона показала, що потужна технологія може бути доступною не лише корпораціям, а й студенту з ноутбуком чи ілюстраторці з домашнім комп’ютером. Хай як складуться суперечки про авторство й етику, ця можливість уже змінила спосіб, у який люди створюють візуальні образи. Якщо ви ще не пробували, почніть з найпростішого: відкрийте будь-який інтерфейс, напишіть одне речення про те, що давно хотіли побачити, і дивіться, що з цього вийде.